Showing posts with label ru. Show all posts

2016-12-31

Уроки курса «Алгоритмика»

28 декабря состоялся второй выпуск слушателей курса по алгоритмам в Projector. Пока что именно "слушателей", а не полноценных выпускников, потому что до 100% того, чем может и должен стать этот курс, еще очень далеко. Но чтобы достичь этих 100%, в том числе, нужно подвести некоторые промежуточные итоги. Первая попытка, прошедшая весной и в начале лета, официально позиционировалась как бета-версия, но и вторая, по факту, тоже оказалось пробной, т.к. курс был разделен на 2 уровня сложности и существенно переработан.

Что можно сказать точно — что курс нужен. Эти знания и навыки дают возможность программисту перейти из категории кодера в полноценного разработчика, способного решать задачи любой сложности. Именно такие люди нужны как гуглам и фейсбукам (и поэтому они уделяют такое внимание теме алгоритмов на собеседованиях), так и небольшим амбициозным продуктовым командам. Да и самому себе: это один из аспектов, котороый дает возможность программисту "расправить крылья" и полюбить свою работу, получив возможность сделать ее разнообразной и приносящей гораздо большую отдачу. И то количество людей, которые этим активно интересуются, показывает, что на рынке тоже есть такое понимание. Хотя эти знания относятся к базовым для университетского курса Компьютерных наук, далеко не у всех была возможность их освоить: кто-то пришел в профессию не классическим путем, кому-то не повезло с вузом и преподавателями, кто-то, просто, прогулял и теперь, набравшись ума-разумуа, хотел бы наверстать упущенное.

Другой вопрос, что разным категориям из этой группы людей подходят разные форматы обучения. Для кого-то это онлайн-обучение, для кого-то — классический университет, и только немногие, объективно, готовы к формату интенсивных трехмесячных курсов. Практика показывает, что где-то треть людей, записавшихся и начавших ходить на такие курсы, быстро осознает это и отпадает. В итоге, до конца двух первых курсов у меня доходило чуть меньше половины участников, причем далеко не все из них успешно проходили весь материал. Т.е. помимо тех, кто просто попал не туда и ушел сразу, есть еще примерно такое же количество, которые могли бы получить хороший результат, но этого не произошло. Почему так? В первую очередь, конечно, причина в недоработках с моей стороны.

Наконец, если в востребованности направления алгоритмов в целом у меня нет сомнений, то вот потребность именно в продвинутом курсе пока что не доказана. Да, первый набор был закрыт, но мы сделали ключевую ошибку: не отфильтровали его должным образом, т.к. надеялись, что те, кто в себе не уверен, пойдут на базовый курс. Это сработало лишь отчасти. Второй момент: люди ждут от продвинутых алгоритмов нечто большого, чем только алгоритмов — конкретно, они хотят машинного обучения. И это можно понять: все хотят машинного обучения :) Оно было заключительной частью программы последней итерации курса (и прошло, как по мне, на ура), но из-за этого пострадал весь остальной материал, который объективно не вмещался в формат. Поэтому машинного обучения больше не будет в рамках Алгоритмики Про. Впрочем, ее сомневаюсь, что очень скоро оно появится в виде отдельного курса, т.к. спрос на это направление сейчас зашкаливает.

В итоге, что же такое Алгоритмика Про и есть ли в достаточном количестве те, кому она нужна? Это сложный курс и сложный вопрос. Его основная идея — это погрузить практикующих программистов в проблематику решения реальных алгоритмических задач: работу с данными размером как минимумом в гигабайты, или реальными графами с миллионами узлов, разобраться в том, как функционируют современные базы данных, редакторы и системы контроля версий, изучить различные алгоритмы оптимизации и применить их для задач из окружающей действительности, залезть под капот сервера и уменьшить время ожидания запросов в его очереди. К сожалению, пока что я только нащупываю это направление. С одной стороны, не все практические проблемы, до которых можно дотянутся, лежали на поверхности (хотя сейчас по опыту двух курсов эта тема для меня довольно неплохо прояснилась). С другой — для этого не было достаточно готовности, вовлеченности и отдачи со стороны участников. Много ли у нас программистов, которые хотят прокачаться в алгоритмической разработке, находятся на должном уровне и готовы выделить для этого большой кусок времени в течение трех месяцев — вот это главный вопрос, ответа на который мы пока не знаем. Такие люди, одназначно, были на первых двух моих курсах. Но, к сожалению, их можно было сосчитать на пальцах одной руки, когда нужно было бы задействовать хотя бы четыре...

Основные вызовы курса для меня

Первый из них я, фактически, описал выше. С самого первого дня обсуждения мы говорили о том, что этот курс должен быть максимально практичным. И я честно старался добиться этого. Но практичность имеет разные аспекты: один аспект — это практическая работа, т.е., в данном контексте, банальное программирование. К сожалению, мне не удалось привлечь к этому каждого участника, хотя по моими прикидкам и прошлому опыту казалось, что это произойдет естественно. Второй аспект практичности — это обсуждение (и реализация) примеров из реального мира, где это все используется. Этому я также старался уделять должное внимание: как рассказывать кейсы на лекциях, так и давать подобные задания (хотя их было меньше, чем могло быть), так и в аспекте курсовой работы. К сожалению, эта часть, как по мне, основывается на первой, т.е. активном программировании, а без него она тоже сильно буксовала. Это проблема номер один, которую я намерен активно решать в рамках следующего курса.

Она также упирается в наличии удобной среды для такой работы у каждого участника курса, а также ее единства для всех участников, чтобы можно было где-то подталкивать продвижение вперед. Я начал первый курс с демонстрацией примеров кода на Лиспе. Это не всем нравилось, хотя все был об этом честно предупрежденны. В итоге, второй вариант был более абстрактным: описание алгоритмов на доске без привязки к тому или иному языку. Этот AB-тест показал, что так не работает: нужно иметь под рукой код, который можно пощупать и покрутить, и который можно подкинуть человек, который застрял, чтоб он мог двигаться дальше. Учитывая мою собственную привязку к Лиспу, а также то, что язык хорошо подходит для реализации алгоритмов, я планирую продолжать настаивать на его использовании. Почему не Python или что-то другое? Во-первых, многие языки не очень пригодны для изучения алгоритмов вообще: яркий пример — это JavaScript, который слишком не четок, не имеет полноценной поддержки арифметики и нужных структур данных, другая крайность — это статические языки, особенно низкоуровневые, которые, с одной стороны, дают много возможностей для оптимизации, но, с другой, вносят слишком много ограничений (в частности, более сложный процесс разработки) и избыточной сложности. Что до Питона, то он более-менее подходит, но я его, по-просту, не люблю, тем более, что курсов по алгоритмам на Питоне хватает. Что ж до конкретно Лиспа и его особенностей: я считаб, что это хороший фильтр, которых нам не хватало при наборе на предыдущие курсы. На самом деле, разобраться в Лиспе на базовом уровне, необходимом для этого курса, не сложно. И если у человека не хватает мотивации и доверия, чтобы это сделать, это многое говорит о его дальнейшей мотивации преодолевать трудности во время самого курса. А, как показала практика, цитируя одного из студентов курса, "Сам факт, що лекція коштує 550 грн, ще не має достатньо стимулючого ефекту," щоб виконати домашнє завдання :(

А зачем, вообще, платить?

Очевидный и резонный вопрос, на который должен ответить для себя каждый желающий пройти этот курс — это вопрос, стоит ли он того и зачем, вообще, платить? Ведь есть интернет, википедия и прекрасные онлайн-курсы, на которых можно изучить то же самое. И это, действительно, так! В отличие от онлайн-курсов, оффлайн-курсы не могут быть бесплатными, поскольку они должны окупать аренду помещения и другие расходы, достойную оплату преподаваталя и персонала, и давать какую-то прибыль организаторам. И к ним не применима фримиум-модель, которую используют Курсера и другие. Да и, вообще, за все в жизни нужно платить.

Но если взглянуть с практической стороны, ROI любого обучения — это отношение полученного результата к затратам денег и времени на его достижение. По-идее, оффлайн-курсы могут выигрывать за счет более высокого среднего результата и меньших затрат времени. Что может войти в этот лучший результат?

  • во-первых, как ни банально это звучит, "волшебный пендель", т.е. внешняя мотивация пробежать этот забег от начала и до конца. И вложенные деньги тоже являются частью этой мотивации, хотя, как показывает практика, не достаточной. В этих курсах пока не было соревновательного момента, который присущ классическому обучению, и это еще одно направление, над которым нужно немного поработать (наметки есть)
  • во-вторых, возможность личного общения с преподавателем и другими учениками. Для меня это, на самом деле, одна из главных мотиваций делать этот курс: возможность взаимодействия с программистами, которые ищут и хотят развиваться в профессии. Парадокс в том, что даже не смотря на то, что я получаю неплохие деньги за этот курс, я все равно зарабатываю больше за основную свою работу. Т.е. меньший заработок должен компенсироваться чем-то другим. Для меня это другое — это возможность со-творчества с участниками курса. А это значит, что мы должны быть на одной волне и идти, в первую очередь, иметь желание попасть на занятие и провести его полноценно. В идеале, завязавшиеся во время обучения связи должны быть одним из главных долгосрочных активов после окончания курса
  • комфортная среда обучения и общения, причастность к сообществу. Projector делает очень важное дело, создавая на основе своей площадки сообщества профессионалов в сфере дизайна, продуктовой разработки и программирования (а также, в будущем, я думаю и других областях)

Кому стоит и не стоит идти на курсы по алгоритмам в Projector

Для меня, на самом деле, это ключевой вопрос всей этой темы. Ни я, ни Projector не ставим себе цели массовости и сверхприбылей. Во-первых, это не устойчиво и закончится пшиком, во-вторых, никакого внутреннего удовлетворения от такой работы не получишь. Между группой из 8-10 мотивированных людей, которые знают, куда и зачем пришли, и 20 вольно интересующимися я выбираю первый вариант, хотя второй, на самом деле, проще. Первые две итерации курсов были поиском: поиском правильного формата и адекватной ему аудитории.

Мой вывод следующий: эти курсы подходят тем, кто

  • уже имеют некоторый опыт программирования (в идеале, хотя бы пару лет)
  • осознал для себя ценность алгоритмов, и не будет мучаться вечным вопросом украинского студента: "где же это все применяется в реальной жизни?" Ответ на него, с моей точки зрения: кто хочет, тот найдет. Спрос на алгоритмических программистов есть, и хотя он не более нишевый, но в нишах всегда больше и интерес, и доходы
  • готов (как психологически, так и организационно) 3 месяца стабильно уделять минимум 10 часов в неделю этим занятиям, а также, что еще более важно, уделять им основной ресурс своего мозга. Практически, это означает, что в это время не удастся полноценно интенсивно работать. Как показали эти 2 курса, самое лучший период для участия в этой авантюре — это либо перерыв между работами, либо последние курсы вуза. Те, кто пытаются одновременно интенсивно работать в разработке и учиться, либо забивают на курс, либо жалуются, что работа начинает страдать, либо берут отпуск, чтобы подтянуть хвосты. Также это может прокатить для тех, у кого работа сейчас не предполагает активное написание кода. Если же вы только что поменяли работу, как раз должны заканчивать важный проект, ожидаете рождения ребенка (да, и такие случаи уже бывали :) или же собираетесь уехать в середине в отпуск или коммандировку, то этот формат точно не для вас

2016-01-03

КПИ no more

Это последний год, который я читаю в КПИ курс "Операционные системы". Пролистав архив переписки, я сделал вывод, что начал это делать в 2009 году, т.е 6 лет назад, и за это время через меня прошло более 500 студентов. Выходит, я проработал преподавателем уже больше, чем проучился в институте, иными словами мой долг перед альма матер можно считать исполненным :)

В этом тексте я хочу описать свой опыт и ответить на вопрос, почему решил уйти. Начнем с конца: потому что, кроме меня, это, по большому счету, никому не нужно. А у меня с каждым годом все меньше и меньше времени делать никому не нужные вещи.

А теперь по порядку.

Шесть лет назад я начинал создавать этот курс с чистого листа. Что мне нравилось, это то, что был полный карт-бланш для экспериментов и выбора методик преподавания, и это дало возможность попробовать много всего и понять, что работает (для меня), а что нет. Для студентов это не всегда было благоприятно, т.к. далеко не все эксперименты были успешными, но, все же, я считаю, что это лучше, чем то, что было у нас, когда этот курс просто спускался на тормозах (это, собственно, и была моя изначальная мотивация прийти читать его). Каждый год я ставил себе условную оценку за проделанную работу, и если вначале это была твердая двойка, то сейчас, я считаю, что это минимум 4 или 4+ (в прошлом году я также попросил студентов поставить мне оценку, и у них тоже в среднем вышла четверка).

В целом, курсом я преследовал такие цели:

  • ввести студентов в парадигму системного программирования, показать ее интересные стороны и задачи
  • дать им альтернативный взгляд на разработку ПО (а не только ООП и C#, которые являются основными на нашей кафедре)
  • научить работать с Unix-средой и консолью
  • научить не боятся ассемблера и, вообще, низкоуровневых вещей
  • чуть-чуть познакомить с новыми языками прогарммирования, которые актуальны для системной разработки
  • познакомить с опен-сорсом
Не все из этих целей я достигал в рамках курса в тот или иной год: иногда получалось лучше что-то одно, иногда другое, но, думаю, что все они акутальны. Кроме того, если задаться целью, то на основе этого курса легко можно сделать продвинутое продолжение — "Разработка ОС" (аналог MIT Operating System Engineering). За 6 лет удалось собрать достаточно материала, который доступен в виде конспекта и заданий (а также исходников к ним). Более того, в качестве побочного продукта я разработал небольшую систему публикации материалов (свой leanpub), а также тестирования теории. Единственное, до чего так и не дошли руки — это система автоматического тестирования лабораторных. Если придумать, как эффективно масштабировать такую штуку, то это был бы, действительно, золотой грааль, но, к сожалению, основная работа тут, кажется, все равно будет заключаться в написании ручных тестов. А главный закон преподавателя: ручная проверка практических работ — самый большой убийца мотивации...

Почему это никому не нужно в КПИ?

Четыре года назад я написал колонку на ДОУ "Украинский Стенфорд", в которой изложил свой ограниченный взгляд на проблемы, вызовы и возможности нашего высшего технического образования. С тех пор ситуация конкретно в КПИ скорее ухудшилась: ушли многие из старых профессоров, многие из хороших молодых преподавателей также по разным причинам не задержались, так что еще лет 5 и на ФИВТе преподавать, похоже, останутся только люди, не имеющие особого отношения ни к индустрии, ни к науке. Впрочем, это не значит, что такая ситуация везде: мне кажется, сейчас достаточно 1-2 ориентиованных на модернизацию людей в руководстве какого-то факультета или кафедры, чтобы организовать там вполне качественное обучение (все остальное, в принципе, есть). Иными словами, с моей точки зрения основным тормозом изменений университета сейчас является его руководство (на всех уровнях). В связи с этим интересно посмотреть, как будет развиваться ситуация в ХНУРЕ, куда ректором пришел Эдуард Рубин...

Что также интересно, внешне КПИ меняется в лучшую сторону. Хорошо развивается кампус, причем в этот процесс активно включились студенты с такими проектами, как БелкаВежа или Радио КПИ. Много движения в культурной и социальной жизни (вопреки инерции системы). Отличная инициатива — Летняя школа, которая проходит уже 10 лет и в которой я участвовал последние 2 года. В прошом году мы даже провели TEDxKPI! Обычно, такие позитивные внешние проявления следуют за изменением внутренних процессов, но тут имеет место несколько иная динамика: университет — это по определению открытая система, которая постоянна испытывает приток новой крови, и среди этой новой крови действуют те же тренды, что и по всей стране ("бери и делай"). Но, в то же время, с такой же легкостью, с которой новая энергия прибывает сюда, она здесь и надолго не задерживается: активным студентам почти нет стимула оставаться в аспирантуре, а для многих преподавателей это, фактически, волонтерство (например, моя зарплата в КПИ более чем в десять раз меньше тех денег, которые я могу заработать в индустрии), которое почти всегда не стабильно. Именно поэтому я говорю о том, что при ситуацию можно было бы поменять при правильной ориентации руководства: на улучшение качества студентов (за счет их количества), поддержку новых инициатив, уменьшение бюрократии.

Однако, к сожалению, стратегического видения развития университета нет.

С моей точки зрения, есть 2 рабочих модели высшего образования:

  • элитарная, когда отбирается небольшое количество самых талантливых и мотивированных студентов и преподаватель работает с ними индивидуально (к ней есть хороший "анекдот" про астрофизика, который читал свой курс в какой-то далекой обсерватории только для двух студентов, оба из которых потом стали Нобелевскими лауреатами)
  • массовая, когда набирается большая группа студентов и их всех подтягивают до какого-то базового уровня

Очевидно, что КПИ реализовывает второй подход: на последнем потоке второго курса, которому я читал, учится около 100 человек. И таких потоков по направлению компьютерных наук в университете несколько. Но чтобы массовая система работала, она должна быть действительно системой (в которой нет слабых звеньев). В первую очередь, студенты должны быть мотивированы. По принципу кнута и пряника.

Позитивной мотивацией должно быть желание получить современную и перспективную специальность, а в процессе делать интересные и прикольные штуки, а негативной — реальная возможность вылететь. К сожалению, в КПИ обе эти мотивации недоразвиты. По большому счету, в наших реалиях на первом и втором курсе нужно выгонять минимум 20% студентов (примерно столько людей у меня на курсе вообще ничего не делает по ходу семестра и начинают пытатся что-то сдать в лучшем случае к его концу, если не к сессии). Но систематической политики выгонять нет, скорее, наоборот, есть вялое сопротивление тем, кто пытается это делать.

Что до позитивной мотивации, то в КПИ ее перебивает передающаяся из поколения в поколения совковая традиция этого университета, который можно выразить несколькими популярными у студентов мемами:

  • главное — это сдать зачет/сессию/получить диплом (и для этого хороши все способы, в том числе обман)
  • то, чему нас учат, никогда не понадобиться в реальной жизни
  • лучший друг студента — это шара
Но хорошая новость в том, что спрос на качественное техническое образование есть и он никуда не денется, и чем больше будут деградировать существующие институции, тем больше места будет открываться для новых начинаний и форм. Я думаю, что в течение ближайших 5 лет у нас появится минимум 1 технический "университет" нового образца, в котором можно будет получить образование на мировом уровне (как я написал, для этого, в принципе, есть всё, кроме некоторой доли лидерства). Я также надеюсь, что сам смогу чем-то помочь в этом. Но, чтобы начать что-то новое, нужно сначала завершить старое. Жаль только, буду скучать за парком КПИ, тополями и каштанами...

2015-04-07

Креш-курс по Лиспу - кому он будет интересен


В июле должен состояться мой мастер-класс введение в практическую разработку на Common Lisp. По этому случаю меня попросили написать статью в блог компании SmartMe, которая проводит это мероприятие. В ней я попытался ответить на вопрос, кому и зачем сейчас может быть интересно разобраться с Лиспом.

Лисп — один из самых старых и, пожалуй, самый загадочный из современных языков программирования. Также бытует мнение, что он не просто стар, а устарел. Почему это не так и где его ниша, я попробую ответить в этой статье.

Лисп — пожалуй единственный динамический системный язык программирования. И среди динамических языков он остается непревзойденным выбором благодаря следующими свойствам:
  • реальной мультипарадигменности, дающей возможность элегантно совмещать процедурный, объектно-ориентированный, функциональный и другие стили
  • уникальной поддержке метапрограммирования
  • легендарной интерактивной среде разработки
  • железобетонному стандарту языка, за которым стоит многолетняя работа мегаумов МИТа, Xerox PARC, CMU и других подобных мест, оплаченная DARPA
  • обширному набору реализаций (компилятор и среда исполнения), коих разработано за его историю около 25, до 10 из которых активно поддерживаются и развиваются
На самом деле, современное положение Лиспа как языка, который обычно не рассматривают для серьезной разработки, обуcловленно отнюдь не техническими причинами, а лишь исторической случайностью — язык сильно опередил свое время,— и человеческим фактором: он и не выбор по-умолчанию (как С++, Java или JavaScript), и не модная новая технология (как Scala, Go или Ruby), и не имеет за собой какую-либо серьезную организацию или сообщество, которые бы продвигали его использование (как C#, Swift или Rust). Тем не менее, миф о непрактичности Лиспа опровергает как мой опыт использования его в ядре Grammarly и предыдущих моих коммерческих проектах (уже более 7 лет), так и опыт поисковика авиабилетов ITA Software, купленной Гуглом за миллиард долларов, или же португальской Siscog, разработчика решений для железных дорог, в которой работает более полусотни Лисп-программистов. А адепты теории о необходимости его модернизации могут почитать Changelog SBCL (лидирующей open source реализации) :)

Конечно, у Лиспа есть и недостатки — помимо небольшого сообщества, представленного в основном энтузиастами, это:
  • непривичный синтаксис
  • часто непривичные подходы и способы разработки
  • отсутствие библиотек для взаимодействия с остальной средой (проект Quicklisp давно доказал обратное :)
Таким образом, еще раз можно повторить, что язык и экосистема Common Lisp не имеет серьезных технических недостатков при ряде бесспорных преимуществ, но он слишком непривычен и нетипичен, поэтому страдает от проблемы курицы и яйца: отсутствие Лисп-программистов не позволяет начинать на нем серьезные проекты, а отсутсвие импульса в сообществе не приводит в него новых программистов. Поэтому, Лисп вряд ли будет в ближайшее время серьезно использоваться в индустрии разработки. В чем же тогда его ниша сегодня? Если оставить за скобками тренды, то я бы сказал, что в первую очередь, это системы, которые пишутся на годы и должны постоянно эволюционировать: в этом плане он находится в точке золотой середины между классическими системными языками, типа C++ и Java, и их динамическими конкурентами, предоставляя невероятно гибкую и, в то же время, достаточну производительную (как в отношении скорости исполнения, так и скорости разработки) среду. Особенно, если такие системы должны иметь средства представления и обработки большого количества знаний. Как раз про них 10-е правило Гринспена:
Any sufficiently complicated C or Fortran program contains an ad hoc, informally-specified, bug-ridden, slow implementation of half of Common Lisp.
Однако, очень мало кто решится писать сейчас такие проекты на Лиспе. Более актуально другое его применение — быстрое прототипирование и среда для экспериментов. В этой нише у Лиспа много конкурентов, таких как Python или же специализированные языки, типа R и MatLab, но преимущество Лиспа в том, что удачный протип можно со временем довести до продакшн системы. Однако, самое важное значение Лиспа для меня — это полная свобода творчества, которую он предоставляет. Кроме шуток, доступ к такой среде дает возможность программисту развиваться не просто набором опыта использования каких-либо инструментов и фреймворков, а через решение нестандартных задач пытаясь найти для этого наиболее удачный способ независимо от случайных ограничений, налагаемых текущими обстоятельствами и принятыми нормами.

2013-09-04

Ищем Лиспера с горящими глазами

Уже 3 года я работаю в Grammarly, где мы строим (и довольно успешно) самый точный сервис исправления и улучшения английских текстов. В экстремуме эта задача упирается в полноценное понимание языка, но пока мы не достигли этого уровня, приходится искать обходные пути. :) Понятно, что работы у нашей команды, которую мы называем "core team", выше крыши. Но эта работа довольно сильно отличается от обычной программной инженерии, точнее, инженерия — это ее конечный этап, которому предшествует огромное количество экспериментов и исследования.

Я как-то назвал нашу систему Grammar OS, поскольку она чем-то похожа на ОС: в ней есть низкий уровень языковых сервисов, есть промежуточные слои проверщиков, есть и пользовательские приложения. Одним из ключевых компонентов является написанная на Лиспе и постоянно развивающаяся система проверка грамматики. Этот проект помимо собственно сложной задачи, на которую отлично легли возможности Лиспа, high-load'а, также интересен и тем, что над ним работают около 5 компьютерных лингвистов, которые все время дописывают в него какой-то код...

К чему я это веду, это к тому, что мы уже больше полугода ищем Лисп-разработчика, желающего подключиться к развитию этой системы, а в перспеткиве и к работе над новыми Лисп-проектами, о которых мы думаем. Помимо Лиспа в ядре у нас используется много Джавы (даже больше), и мы, в общем-то, ее тоже любим. И немного Питона. А основной фокус сейчас все больше и больше сдвигается в сторону различных алгоритмов машинного обучения.

Наконец, у нас в Grammarly отличная атмосфера и куча людей, у которых есть чему поучиться.


В общем, как по мне, практически работа мечты для программиста, которому нравится обработка текстов, R&D или Лисп. Логичный вопрос: почему же мы так долго не можем найти подходящего человека? Ответов несколько:
  • Во-первых, мы всех нанимаем очень долго (почти полгода искали даже Java-разработчика). Почему — смотри выше — качество команды для нас важнее скорости.
  • Во-вторых, лисперов с индустриальным опытом у нас не так и много: в Киеве их от силы пару десятков, в России — больше, но мало кто из них хочет переезжать.
  • В-третьих, даже у технически сильных кандидатов часто не горят глаза :(
Короче говоря, ситуация такова:
  • Есть сложная и интересная работа, с хорошей зарплатой, отличной командой, компанией и перспективами.
  • Нужен увлеченный своей работой программист, который хорошо понимает алгоритмы, математику и статистику, и хочет писать на Лиспе.
  • Опыт на Лиспе нужен, но не обязательно из реального мира: open-source или хобби-проекты тоже покатят. Но тогда важно желание и способность быстро развиваться в этом направлении.
Если что, пишите на vseloved@gmail.com...

2012-12-14

Ansi Common Lisp на русском

Недавно вышел русский перевод книги Пола Грема "Ansi Common Lisp", к которому я немного приложил руку в качестве "научного" редактора. На форуме lisper.ru уже были сообщения от счастливых обладателей бумажной версии книги, а на сайте издательства даже доступен ее электронный вариант по свободной цене.

Хотя изначально я скептически отнесся к выбору именно этой книги для перевода, сейчас я рад, что так вышло. Работая над переводом, хочешь-не хочешь, а пришлось прочитать книгу практически от корки до корки, и могу сказать, что это, пожалуй, самое краткое, простое и доступное введение в язык. Practical Common Lisp лучше открывает глаза, и все-таки остается самой лучшей книгой по Lisp'у в целом, но он существен больше. В общем, ANSI CL — очень хороший вариант для начинающих. И хотя стиль Пола Грема часто критикуют в современном Lisp-сообществе, эта книга достаточно сбаллансированна и не содержит каких-то апокрифических мыслей :)

Книга состоит из двух частей, меньшая из которых — справочник — фактически бесполезна из-за наличия Hyperspec'и. Но это хорошо, поскольку остается меньше текста для прочтения :) Первая же часть состоит из 13 глав, описывающих разные аспекты языка, и 3 глав с решением практических задач. Главы про язык содержат множество примеров использования различных структур данных и реализации с их помощью нетривиальных алгоритмов, что может позволить неплохо прокачать это направления тем, кто не занимается постоянным решением алгоритмических задачек на Codeforces. Особенно, учитывая красоту и ясность реализации этих алгоритмов на Lisp'е. Несколько глав были весьма полезны и мне с моим пятилетним практическим опытом использования языка: например, я смог по достоинству оценить элегентность structs и стал намного больше пользоваться ими, интересными также были главы про оптимизацию и структурирование программ. В последних 3 главах разобраны классические для Lisp'а задачи: логический вывод, создание своей объектной системы (фактически, реализация внутренностей JavaScript'а) и генерация HTML из мета-языка — это те вещи, на которых видны некоторые из самых сильных сторон языка.

Из-за проблем издательства работа над переводом велась очень долго — что-то около двух лет. Точнее, сама работа длилась намного меньше, но ее отдельные части были разделены большими временными промежутками. Переводил allchemist, и сделал это задорно и весело. Своей задачей я видел прежде всего исправление отступлений от оригинала и работу с терминологией. Что касается второго пункта то тут я хотел напоследок рассказать занимательную историю про стог и пул.

Стог и пул

Пару лет назад Иван Сагалаев, который выступал в той же роли научного редактора для книги "Coders at Work", написал следующее по поводу роли научного редактора:

Кто не знает, научный редактор — это человек, совершенно необходимый для специальной литературы. Он берёт сырой перевод и приводит специфичную терминологию в соответствии с принятой в реальном мире. В результате вы читаете книжку, в которой написано не "процесс синтаксического разбора", а просто "парсинг", и не "интерфейс прикладной программы", а "API".

Применительно к Кодерам, которые должны читаться как приключенческий роман, я согласен с подходом Ивана. Но вот что касается таких книг, как ANSI CL, предназначеных прежде всего для (относительных) новичков, я считаю, что выбор должен делаться в сторону максимальной понятности терминов, а не привычности их для людей, которые уже в теме. Т.е., конечно, не "процесс синтаксического разбора", а просто "синтаксический разбор" и местами "разбор" — но не "парсинг". Почему? Да хоть потому, что "парсинг" для новичка создает некий магический ореол вокруг этого термина и выделяет его из ряда других, названных на родном языке, хотя ничего выделяющегося в нем нет. Да, часто подобрать адекватный термин на родном языке очень трудно, порой их даже приходится изобретать, но именно так и происходит развитие терминологии.

По этому поводу в этой книге было 2 очень интересных примера, за первый из которых меня можно смело закидывать помидорами, но я все же буду продолжать настаивать на нем. Давайте перечислим абстрактные структуры данных, с которыми мы чаще всего встречаемя — это, конечно же, лист, три, кью, стек, хип, дек. Ой... Т.е., я хотел сказать: список, дерево, очередь, куча, колода и... стек. Как-то так вышло, что у всех этих структур имена как имена, а вот стек какой-то особенный. Почему? Наверно, из-за лени, но не важно. Если заглянуть в словарь, то для английского слова "stack" можно найти 2 вполне подходящих перевода. Первый из них — стог :) По-моему, удивительный случай созвучности, и, по-своему, очень забавный вариант. Именно его я предложил использовать в качестве термина, когда речь идет об этой структуре данных, и он продержался практически до последней ревизии, однако, в последний момент все-таки был заменен на менее одиозный вариант стопки. Это тоже хороший перевод и с точки зрения соответствия реальности даже более адекватный, так что я остался доволен. Удивительно, почему он так редко встречается в литературе!

Но тут есть еще одна трудность: а как быть со стеком вызовов функций программы, который уже не абстрактная структура данных, а конкретное технологическое решение, вокруг которого есть еще и другие термины, типа "stacktrace"? Вот тут, конечно, намного труднее, и я остановился на том, что в данном случае, чтобы не создавать путаницы, лучше использовать устоявшийся термин, т.е. стек. Возможно, с прочным вхождением в обиход стопки, можно будет перенести этот термин и сюда: стопка вызовов — звучит банально. Зато никакой дополнительной случайной сложности :)

Вторым термином, которым я остался недоволен, был пул. Тут случай хуже, т.к. адекватного перевода его на русский и вовсе нет. Ну не бассейн же. Я так ничего и не придумал. Но, если у вас будут мысли на эту тему, делитесь...

2012-12-12

Утилитарный Lisp

Вот как выглядит "клиент" (если для такого простого кусочка кода уместно столь громкое название) для набирающего популярность лог-сервера Graylog2 на современном Lisp'е: По-моему, этот кусочек кода неплохо развеивает миф о проблемах с библиотеками в Lisp-среде: в нашем пайплайне сначала сообщение сериализуется в JSON библиотекой cl-json, затем кодируется в байтовый поток babel, затем зипуется salza2, а затем отправляется через UDP-шный сокет usocket. А еще есть повод использовать прекрасную библиотеку для работу со временем local-time, основанную на статье Эрика Наггума. Ну и чуть-чуть синтаксического сахара из rutils, в том числе и буквальный синтаксис для хеш-таблиц (как в Clojure), модульно подключаемый с помощью named-readtables. Ничего лишнего.

2012-08-20

Как сочетать функциональные языки и мейнстрим

Где-то с месяц назад меня позвали на киевскую тусовку функциональных программистов рассказать про практический опыт использования Clojure. В итоге я немного покритиковал Clojure, но в основном хотел сказать несколько о другом: о том, где ниша функциональных и других немейнстримных языков (например, Lisp'а), и как их можно использовать в сочетании с мейнстримными. Получилось, как всегда довольно сбивчиво, поэтому попробую изложить здесь яснее и структурированнее.

Вот видео:


А хотел сказать я всего-то 3 простые вещи, в которых нет ничего особенно нового, но от этого они, как по мне, не теряют своей ценности.

1. Философия Unix для веба


Если говорить о серверной разработке, то самым эффективным подходом к построению масштабируемых систем (как в смысле нагрузки, так и трудоемкости их развития) был и остается Unix way:
small pieces, loosely joined, that do one thing, but do it well

Только в отличие от классики Unix, теперь эти кусочки живут в рамках отдельных узлов сети и взаимодействуют не через pipe, а через сетевые текстовые интерфейсы. Для того, чтобы организовать такое взаимодействие существует ряд простых, надежных, хорошо масштабируемых и, что очень важно, де-факто стандартных и языконезависимых средств. Под разные задачи эти средства разные, и они включают:
  • низкоуровневые механизмы взаимодействия: сокеты и ZeroMQ

  • высокоуровневые протоколы взаимодействия: HTTP, SMTP, etc.

  • форматы сериализации: JSON и еще десяток других

  • точки обмена данными: Redis, разные MQs
Это не REST и не SOA в чистом виде, скорее перечисленные схемы являются несколько специализированными, а иногда и ушедшими сильно в сторону ппримерами воплощения этого подхода. Это не более и не менее, чем инструментарий, поверх которого можно построить любую сетевую архитектуру — от централизованной до P2P.

2. Требования к языкам


Когда программисты сравнивают между собой разные языки, они, как правило, подходят к задаче не с той стороны: от возможностей, а не от требований. Хотя работа в индустрии должна бы была их научить обратному. :) Если же посмотреть на требования, то их можно разделить на несколько групп: требования к языкам для решения неизвестных (исследовательских) задач существенно отличаются от требований к языкам для реализации задач давно отработанных и понятных. Это классическая дихотомия R&D — research vs development — исследования vs инженерия. Большинство задач, с которыми мы сталкиваемся — инженерные, но как раз самые интересные задачи, как с точки зрения профессиональной, так и экономической — исследовательские. Также отдельно я выделяю группу требований для скриптовых языков.

Требования к языкам для исследований

  • Интерактивность (минимальное время цикла итерации)

  • Поддатливость и гибкость (решать задачу, а не бороться с системой)

  • Хорошая поддержка предметной области исследований (если это математика — то хотя бы Numeric Tower, если статистика — то хорошая поддержка матриц, если деревья — то инструменты работы с деревьями и первоклассная рекурсия, и т.д.)

  • Возможность решать задачу на языке предметной области (заметьте, что специфические исследовательские языми — всегда DSL'и)

Требования к языкам для решения стандартных задач

  • Поддерживаемость (возможность легко передать код от одного разработчика другому)

  • Развитая экосистемы инструментов и хорошая поддержка платформы

  • Стабильность и предсказуемость (как правило, мало кто любит истекать кровью на bleeding edge, поэтому выбирают то, что работает просто, но без особых проблем, проверенное)

  • И, порой самое важное — возможность получить быстроработающий результат (подчас скорость работы отличает решение, которое пойдет в продакшн, от того, которое не пойдет)

Требования к скриптовым языкам

  • Первое и основное — хорошая интеграция с хост-системой (оптимизация языка под наиболее часто выполняемые операции в хост-системе)

  • Простота и гибкость (я еще не слышал ни об одном статически типизированном скриптовом языке :)

  • Минимальный footprint (с одной стороны вся тяжелая работа может делаться на стороне хост-системы, с другой стороны — обычно ресурсы ограниченны и очень мало смысла тратить их на ненужное)

Очень много можно рассуждать о том, какие требования стояли во главе угла при создании тех или иных языков, как языки эволюционируют и т.д. Ограничусь лишь тем, что выделю группу языков, которые однозначно создавались чисто для исследовательской работы — это Matlab, Octave, Mathematica, R, Prolog и разные вариации на тему. Слабость таких языков обычно в том, что в них не были заложены общеинженерные механизмы (прежде всего, первоклассная поддержка взаимодействия с другими системами, которые живут за пределами их "внутреннего" мира).

Один из классических подходов к решению исследовательских задач — двухэтапный метод: разработать прототип системы на исследовательском языке, а затем реализовать полноценную систему уже на инженерном языке, оптимизировав при этом скорость и другие показатели решения, но не меняя его сути. Самым существенным недостатком у него, как по мне, является то, что это может неплохо работать в случае одноразового решения, но если система должна эволюционировать во времени, то все становится существенно сложнее. Ну и, зачем делать дурную работу: хорошо, если язык может поддерживать как исследовательскую, так и инженерную парадигму.

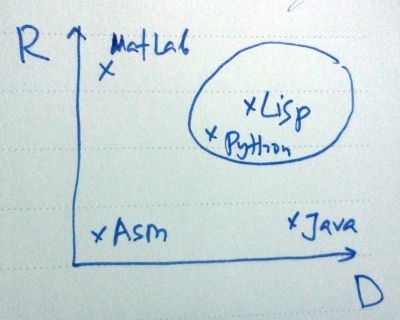
Если предаставить эти требования в виде декартовых координат, и расположить на них языки, и обевсти самую интересная область, в нее попадет совсем немного языков — раз-два и обчелся. Прежде всего, это Lisp, также Python, и, может быть, еще пара-тройка.


3. Выбор языка под задачу, а не под платформу


Возвращаясь к нашему Unix'у в облаках, отдельные компоненты этой системы могут быть написаны на любом языке (также, как и на обычном Unix'е) и даже работать на любой платформе. Это дает возможность решать специфические задачи тем инструментом, который подходит лучше всего. И среди всего спектра задач преобладают в основном такие, которые, по большому счету все равно, на каком языке делать. Для этих задач обычно самыми главными критериями выбора являются экосистема инструментов и в половине случаев скорость работы результата (во всяком случае в долгосрочном плане).

Но не все задачи такие: есть много разных областей, в которых мейнстримные языки работают плохо или же фактически не работают вообще. Известный афоризм на этот счет — 10е правило Гринспена. Соответственно, если вы хотите использовать Lisp, Haskell или Factor — решайте на них те задачи, на которых они дают очевидное преимущество, и делайте их полноценными гражданами в облачной экосистеме. Так вы на практике, а не в теории сможете доказать их полезность скептикам, и в то же время будут развиваться как знания остальных программистов о них, так и инструментарий этих языков (по которому они часто проигрывают мейнстримным аналогам). Таким образом, в будущем они получат возможность рассматриваться как кандидаты для решения и других задач, для которых их преимущества не столько очевидны (в 2-3 раза, а не на порядок).

P.S. Пару слов о Clojure


В выступлении я много сравнивал Erlang и Clojure. Оба эти языка делают упор на конкурентную парадигму разработки. Но Erlang в этом смысле стоит особняком от других функциональных языков, поскольку конкурирует с императивными языками не столько на уровне качества языка для решения конкретных задач, сколько как язык-платформа, создающий новую парадигму решения задач за рамками отдельного процесса и отдельной машины. Таким образом, его главная ценность — это роль системного языка для распределенных систем.

Что касается Clojure, то я в шутку разделил все языки на фундаментальные и хипстерские. Фундаментальные языки (такие как C, Lisp, Erlang, Haskell, Smalltalk) появляются, когда группы умных людей долго работают над сложными проблемами и в процессе создают не просто язык, а целую парадигму. В то же время хипстерские языки являются продуктом обычно одного человека, который хочет здесь и сейчас получить самое лучшее из нескольких языков сразу, гибрид. Я перечислял такие примеры, как C++ (C + классы + еще куча всего, понадерганного с разных сторон) — это, пожалуй, архетипный хипстерский язык,— Ruby (Perl + Smalltalk + Lisp), JavaScript (C + Scheme), который со времени пояления V8 и node.js перешел из категории скриптовых языков в общесистемные. Кстати, в большинстве случаев языки второго типа более успешны в краткосрочном плане и завоевывают мир. Точнее, их мировое господство чередуется с господством языков, которые стоят в этом спектре где-то посередине: когда люди устают от подобных гибридов, их в конце концов "побеждают" более здравые варианты. Java вместо C++, Python вместо Ruby (для веба), посмотрим, что будет вместо JS. К сожалению, Clojure — яркий пример такого гибрида: это попытка скрестить Lisp с Haskell'ем, да еще и на Java-основе...

2011-12-21

Реальная норма часов работы программиста в день

В 2009-10 годах у меня был некоторый опыт удаленной работы программистом на основе почасовой оплаты. С тех пор я периодически задумывался над тем, сколько же реальных часов работы над кодом в день должен в среднем выдавать программист. На самом деле, этот вопрос, а точнее его последствия, актуален для любого формата работы: как офисной, так и удаленной, так и всего, что между. В "офисном" варианте оплачивается фиксированное время работы и задача в оптимизации реального времени в рамках этого интервала (гибкий график, уменьшение количества встреч и т.п.) Проблемой фриланс-варианта является то, что большинство заказчиков не понимают, что они должны платить не только за время реальной работы над кодом, но и за сопутствующие активности, типа ковыряния в носу, и/или не знают, какое должно быть соотношение этих активностей к собственно программированию.

И вот, на днях на хакерньюз я наткнулся на отличную статью профессиональной писательницы о повышении эффективности ее труда в 5 раз (с 2 до 10 тысяч слов в день). Фактически, ей удалось это сделать за счет выработки метода систематического вхождения в поток. А как все мы творческие работники знаем, поток — это залог эффективной работы*. Но, что в этой статье для меня было действительно важным — это то, что человек, добившийся такой эффективности, констатировал факт: собственно непрерывной работы у нее в среднем 4 часа в день — в самых удачных случаях до 7 — плюс 2 часа с утра, которые расходуются на подготовительную работу. А если вырабатывать больше, то эффективность начинает падать. Не говоря о том, что можно перегореть.

Это наблюдение совпадает и с моим опытом: у меня такое же количество (4-6) часов эффективного писания кода в день. В этом нет ничего удивительного, поскольку труд программиста ничем не выделяется из ряда других творческих профессий: писателя, дизайнера или же композитора. Что же тогда делать с 8-ми часовым рабочим днем? На самом деле, ничего плохого в том, что только 50-75% рабочего времени тратится собственно на работу нет: остальное время тоже не пропадает зря, посколько тратится на комуникацию (без которой любая компания и проект обречены), а также какие-то нерабочие активности, которые формируют ту самую мифическую "корпоративную культуру". И даже если этих активностей нет (фриланс) — это не значит, что: а). программист может это время потратить на работу над кодом б). программисту они не нужны (нужны, возможно, только в другой форме: социализация нужна всем).

Т.е. выходит 2 числа, характеризующие нормального программиста: максимум 6 часов (а в среднем: 4 часа) программирования в день и коэфициент 1.5 соотношения часов программирования к часам работы. И эти числа нужно принять как исходные данные, на основании которых менеджеры могут стоить какие-то предположения, оценки и методики.

Кроме того, такой взгляд разрешает для меня диллему эстимейтов: должен и может ли, вообще, их делать программист?

Функция time профилировщиков программ выдает обычно 2 числа: total time и real/cpu time. Первое значение — это фактическое время, которое прошло от старта программы до завершения. На него могут влиять такие факторы, как кеширование, ожидание ввода-вывода и т.п. А сpu time — это время, которое программа действительно выполнялась на процессоре. По-хорошему, именно это, второе время, может научиться оценивать программист: т.е. время, которое ему понадобиться для написания и отладки кода, когда он будет находится в "разогретом" режиме работы. А вот общее время — которое, на самом деле, интересует бизнес — может научиться оценивать только менеджер, беря во внимание оценки программистов (и их историческое качество), а также 100500 других факторов, которые могут повлиять на режим его работы: кеширование, своевременное заполнение пайплайнов, переключене контекста и т.д.

* Те, кто не знает, может очень быстро узнать из уст человека, который сформулировал эту концепцию (или из его классической книги Flow):

2010-10-17

Роль CTO в технологической компании

Есть известная максима, давно проповедуемая Полом Гремом и взятая на вооружение большей частью американского стартап-сообщества, о том, что технологические стартапы должны иметь минимум двух основателей. Можно много дискутировать на тему, с чем это связанно: например, есть версия, что "если предприниматель не способен убедить в своей идее хотя бы еще одного человека, то он тем более не сможет убедить в этом рынок". Я же пришел к выводу, что всё упирается в ответ на вопрос, что можно аутсорсить, а что нет? Как известно, нельзя этого делать с ключевыми функциями компании. И первой ключевой функцией является формирование ее идентичности на рынке. Этим занимается человек, называемый американцами CEO, хотя более правильно было бы назвать его просто лидером проекта. По своей базе он может быть как инженером, так и маркетологом, финансистом или продажником. Это не столь важно, поскольку его главная роль, которая заключается в том, чтобы вести компанию в правильном направлении и рассказывать об этом рынку через маркетинг, биздев, продажи, PR и т.д. и т.п., не требует особой специализации. Очевидно, что при этом он должен стоять у истоков идеи, которая реализуется, и сам крепко верить в нее, иначе он не сможет убедить в ней других. И эта роль настолько обширна, что она должна быть единственной сферой ответственности такого человека. Да, он может быть крутым программистом и вносить свой вклад, а, воможно, и наибольшее ноу-хау в технологии своей компании, но он не может быть ответственным за эту сферу в целом. Потому что, если отвечать за два дела одновременно, то ни одно из них не выйдет сделать хорошо. И это показывает опыт, в том числе и мой собственный.

Вот здесь и выходит на арену CTO, роль которого в компании заключается в технологическом лидерстве. Часто считается, что СТО должен написать основную часть кода, если это касается софтверного стартапа. Это не обязательно. Код могут написать хоть 10 фрилансеров или 100 миллионов обезьян, поскольку это довольно стандартная работа, и если правильно поставить задачу, с ней прекрасно справится наемный сотрудник. Но вот, что сложно — так это поставить задачу и сформулировать рамки, в которых должен развиваться проект, а потом следить за тем, чтобы они соблюдались. В технологическом бизнесе, как ни крути, а основные риски все-таки технологические. И все остальные участники процесса (наемные сотрудники, клиенты и т.д.) будут их только увеличивать. Единственный, кто может и должен с ними бороться — это СТО.

СТО — это роль того, кто принимает окончательное решение, выбрать технологию Х, за которую выступает разработчик, или Y, которая сейчас на волне хайпа. Это тот, кто не спит ночами из-за того, что не настроен бекап базы данных. Это тот, кто вводит практику ревью кода и добивается ее реального воплощения. Тот, кто отвечает программистам на вопросы: "зачем?", "почему?" и "когда?" Тот, кто отбирает подходящих инженеров. И принимает еще 100500 разных решений, а потом добивается их исполнения. В общем, это тот, кто создает технологическую культуру компании и не дает появляться технологическуму долгу, который в будущем (и, скорее, близком, чем отдаленном) потянет компанию ко дну или же не даст ей развиваться необходимыми темпами.

Так что правило про двух основателей я переформулировал бы так.
На этапе становления у технологического бизнеса есть 2 ключевые роли, которые должны выполнять 2 разных основателя компании: бизнес-лидер и технолонический лидер.

2010-08-13

ASDF как язык описания систем

Это третья статья в серии про ASDF. Первая часть — об ASDF 2, вторая — об архитектуре ASDF.

Как было замечено ранее, ASDF выполняет 2 связанные, но все же довольно разные по требованиям со стороны пользователей функции: описание систем и управление их сборкой. В этой статье я постараюсь перечислить распространенные (и не очень) шаблоны его применения для этих задач, собранные мной из более 70 open-source Lisp библиотек, с которыми приходилось работать. Я думаю, что систематизация этих знаний сослужит хорошую службу Lisp-сообществу и будет полезна как начинающим, так и экспертам, которые смогут усовешенствовать свои техники.

Изначально в этой статье я планировал разобрать все основные шаблоны использования ASDF, но материала оказалось слишком много, поэтому более сложным темам его применения как build-инструмента будет посвящена следующая серия.

Прямые ссылки на полезные вещи:

Начало работы с ASDF


ASDF нельзя назвать инструментом, который можно освоить за 5 минут. Я сам, например, очень долго вникал в идеологию и особенности его работы, и делал это в основном методом проб и ошибок (мануал мне плохо помогал :). Однако, сейчас мне кажется, что эти трудности связанны не с особенностями ASDF (какими-то неудачными архитектурными решениями и т.п.) или Lisp'а, а, в первую очередь, с отсутствием должной документации и best-practices. Именно этот пробел я и хочу заполнить. Да, всё, что будет показано ниже, почерпнуто из широкодоступного кода Lisp-библиотек, однако часто нужны скорее tutorial'ы, которые позволят быстро начать работу и сразу получить ожидаемый результат. Поэтому начнем именно с такого самого простого примера.

Итак, чтобы создать новый проект с помощью ASDF — нужно создать директорию проекта (пусть будет testprj), в которой поместить имеющиеся lisp-исходники (пусть это будет файл app.lisp) и создать в этой директории файл testprj.asd, в который поместить следующую форму:
(asdf:defsystem #:testprj
:components ((:file "app")))
Для загрузки нового проекта в Lisp-среду нужно, чтобы наш testprj.asd файл был в известных ASDF местах. На данный момент поддерживается 2 способа задания таких мест: аналог PATH (*central-registry*) и source-registry (использующий конфигурационные файлы). Самый распространенный подход (в POSIX-окружении) — это создать ссылку на asd-файл в какой-то специальной директории (например, ~/.lisp), которая добавлена в *central-registry*.

В общем полная настройка такого варианта выглядит так:
$ ln -s <path-to-testprj.asd> ~/.lisp/testprj.asd

;; обычно это делается в rc-файле lisp'а (например, .sbclrc)
CL-USER> (push "~/.lisp/" asdf:*central-registry*)

;; далее можно выполнять (для ASDF 2):
CL-USER> (asdf:load-system :testprj)
;; или для любой версии ASDF:
CL-USER> (asdf:oos 'asdf:load-op :testprj)
;; или в большинстве окружений (например, SBCL), даже:
CL-USER> (require :testprj)
Вот и всё.

Другие формы в ASD-файле


На самом деле, ASD-файл — это обычный lisp-исходник, просто с другим расширением, что помогает найти его ASDF'у, поэтому в нем могут находится и другие lisp-формы. Впрочем, прежде, чем помещать туда произвольные формы, стоит очень хорошо подумать. Во всяком случае, ASD-файл следует сохранить полностью декларативным, поскольку большинство инcтрументов, созданных вокруг ASDF, должны иметь возможность просто читать этот файл, не исполняя.

Пакет для defsystem


Единственный класс форм, размещение которых в ASD-файле необходимо (помимо defsystem и некоторых других ASDF-специфичных форм, о которых будет сказано далее) — это формы работы с пакетом.

Сейчас в Lisp-сообществе есть 2 конкурирующих взгляда на то, как это делать:
  • простой — определять системы в пакете ASDF (in-package :asdf)
  • скурпулезный — определять отдельный пакет только для ASDF-описания системы:
    ;; Пример из описания системы ARCHIVE:
    (defpackage :archive-system (:use :cl :asdf))
    (in-package :archive-system)
Лично я являюсь сторонником первого подхода, поскольку он не добавляет избыточной сложности. Его единственный недостаток — в возможном конфликте символов, однако он решается использованием особых символов (#:testprj или :testprj). Единственным случаем, когда вариант отдельного пакета может оказаться препочтительнее — это какие-то очень сложные описания систем с зависимостями от дополнительных пакетов. Впрочем, это верный признак того, что вы делаете что-то не так и, просто, не пользуетесь всеми возможностями ASDF.

Использование символов


Имена ASDF-систем в форме defsystem, как и CL пакетов в defpackage, можно задавать несколькими способами:
  • символом: (defsystem testprj ...)
  • кивордом: (defsystem :testprj ...)
  • неинтернированным символом: (defsystem #:testprj ...)
  • строкой: (defsystem "TESTPRJ" ...)
Мне не сразу стал понятен принцип выбора, но он прост: нужно использовать неинтернированные символы (а все остальные встречающиеся варианты связанны с тем, что авторы просто не знали или не понимали этот вариант :).

Вариант строки, в принципе, эквивалентен, но не эстетичен, киворда — приводит к "засорению" пакета keywords,— а просто символа — подвержен риску конфликта имен (его точно не стоит использовать, если описывать систему внутри ASDF-пакета).

Задание зависимостей


Я бы сказал, что ключевой функцией ASDF является разрешени зависимостей между исходными файлами в рамках одной системы и между разными системами. Все зависимости в ASDF задаются ключевым словом :depends-on в описании соответствующего компонента (файла, модуля, системы и т.д.)

Зависимости от других систем


Разумеется, любая серьезная система существует не в вакууме, а использует множество других библиотек. Несмотря на миф об их отсутствии в lisp-экосистеме :), большие проекты, над которыми мне приходилось работать, как правило, использовали порядка 20-30 сторонних библиотек (включая рекурсивные зависимости).

Предположим, что наш проект использует библиотеку утилит RUTILS. В таком случае нам нужно немного расширить его описание:
(asdf:defsystem #:testprj
:depends-on (#:rutils)
:components ((:file "app")))
Опять же для задания имени зависимости мы используем неинтернированный символ. ASDF позволяет дать и более точное описание такой зависимости (которое пока используется крайне редко, и о котором в отдельной статье, посвященной версиям).

Зависимости между файлами


Если в проекте больше одного lisp-файла, то стандартной практикой является добавления файла packages.lisp, в котором описываются 1 или несколько пакетов, которые будут использоваться (создавать любой неигрушечный проект в рамках cl-user пакета строго не рекомендуется :).

Предположим, что помимо app.lisp, мы также используем файл support.lisp. В таком случае наше описание приобритет следующую форму:
(asdf:defsystem #:testprj
:depends-on (#:rutils)
:components ((:file "packages")
(:file "support")
(:file "app")))
Однако мы не задалт порядок загрузки отдельных файлов, что может привести к неожиданным результатам (скажем, Lisp будет ругаться на форму (in-package #:testprj) в файле support.lisp, поскольку файл packages.lisp еще не загружен. Поэтому эту форму нужно доработать:
(asdf:defsystem #:testprj
:depends-on (#:rutils)
:components ((:file "packages")
(:file "support" :depends-on "packages")
(:file "app" :depends-on "support")))
Тут мы не пишем, что app зависит от packages, поскольку зависимости транзитивны.

Такой последовательный (serial) вариант зависимостей характерен для доброй половины проектов, поэтому для него есть специальная декларация для defsystem: :serial t. С ней наше описание снова упростится:
(asdf:defsystem #:testprj
:depends-on (#:rutils)
:serial t
:components ((:file "packages")
(:file "support")
(:file "app")))
В основе ASDF лежит расширяемая объектная модель компонентов и операций над ними. Некоторые разработчики используют в описании систем прямое имя класса :cl-source-file, а не :file. А вот класса file в ASDF как раз нет: конкретный класс определяется из слота default-component-class модуля (система — потомок модуля) и по умолчанию, конечно, является как раз lisp-исходником.

Помимо этого описан ряд других вариантов, компонент, а также всегда можно описать свой собственный (об этом — в следующей статье).

Например, интересной практикой является подобная декларация компонента:
:components ((:static-file "cl-oauth.asd")
...
(static-file — это любой статичный файл, который не обрабатывается компилятором, например файл лицензии или, как в данном случае, собственно файл описания системы — ведь он обрабатывается только ASDF. Зачем его добавлять? Например, если мы расчитываем, что будем реализовывать какую-нибудь операцию, типа publish-op, для создания дистрибутива из исходных файлов).

Модули


Модули ASDF — это логические компоненты системы, которые объединяют несколько других компонент. Использование модулей позволяет решить 2 задачи:
  • аггрегированно управлять зависимостями

    Скажем, у нас есть 2 части системы: бэкенд и фронтенд, которые зависят от общего файла утилит. И при изменении каждой из них мы не хотим перекомпилировать другую. В таком случае логично будет описать каждую часть в виде отдельного модуля
  • распределить исходники по разным директориям (в какой-то степени это аналог модулей в Python, но без управления видимостью — об этом в следующей статье)
    (defsystem :arnesi
    ...
    :components
    ((:module :src
    :components ((:file "accumulation"
    :depends-on ("packages" "one-liners"))
    (:file "asdf" :depends-on ("packages" "io"))
    (:file "csv" :depends-on ("packages" "string"))
    (:file "compat" :depends-on ("packages"))
    (:module :call-cc
    :components ((:file "interpreter")
    (:file "handlers")
    (:file "apply")
    (:file "generic-functions")
    (:file "common-lisp-cc"))
    :serial t
    :depends-on ("packages" "walk"
    "flow-control" "lambda-list"
    "list" "string"
    "defclass-struct"))))
    ...))
А можно ли разложить файлы по разным директориям не привязываясь к модели зависимостей, которая накладывается модулями? Да. У любого компонента есть слот :pathname, который позволяет явно задать путь к нему. Однако его использование имеет свои особенности — об этом дальше.

Имена компонент и путь к ним


У любого ASDF-компонента есть обязательный аттрибут имя, который используется при его поиске и разрешении зависимотстей. Однако этот аттрибут *не задается* декларацией :name в описании компонента.
(defsystem :ch-image
:name "ch-image"
...)
В этом коде :name "ch-image" несет чисто эстетический смысл (не верите? :)

Имя задается первым символом в декларации компонента: в данном случае ch-image, или же в случае модуля выше — :src, или же "accumulation" для файла там же. Все внутренние функции ASDF умеют работать как с символьным, так и со строковым представлением имен, описанных выше.

Кроме того, у каждого компонента есть аттрибут pathname, который определяет его положение в файловой системе. Однако, в отличие от имени, его как раз можно задать соответствующей декларацией. Например, этот пример задает относительный собственно ASD-файла путь к модулю io.multiplex библиотеки IOLIB: :pathname (merge-pathnames #p"io.multiplex/" *load-truename*).

Если же путь не задавать явно, то он вычисляется из имени, расширения (которое определяется типом компонента) и положения в иерархии модулей. Таким образом для примера задания модуля в arnesi (выше) для компонента :file "interpreter" будет вычислен такой путь: src/call-cc/interpreter.lisp.

Ну и ответ на вопрос, как разбросать файлы по директориям, не используя модули: задать для всех файлов явный :pathname.

Мета-информация


Defsystem-форма позволяет задать большое количество полезных метаданных для системы. Очень важно указать как минимум следующие:
  • :version, например :version "0.0.1" (подробнее о версиях — в отдельной статье)
  • :author или :maintainer (с указанием e-mail'а, чтобы к вам впоследствии смогли обратиться и предложить миллионы за доработку и поддержку вашей прекрасной библиотеки :)
  • :licence — чтобы люди знали, как они могут пользоваться вашими поделками

Платформо-зависимое описание систем


CL предоставляет исключительно удобный механизм условной компиляции и выполнения кода (#+/#-). И как раз в описаниях систем он, разумеется, находит широкое применение:
  • предотвращение загрузки системы в целом — тут интересны примеры из двух альтернативных библиотек для FFI:
    #+(or allegro lispworks cmu openmcl digitool cormanlisp sbcl scl)
    (defsystem uffi ...)

    ;; CFFI: этот вариант, безусловно, правильнее, чем просто тихо ничего не сделать
    #-(or openmcl sbcl cmu scl clisp lispworks ecl allegro cormanlisp)
    (error "Sorry, this Lisp is not yet supported. Patches welcome!")
  • вынесение функций, зависящих от конкретной lisp-среды в отдельные файлы — пример из все того же CFFI:
    :components (#+openmcl    (:file "cffi-openmcl")
    #+sbcl (:file "cffi-sbcl")
    #+cmu (:file "cffi-cmucl")
    #+scl (:file "cffi-scl")
    #+clisp (:file "cffi-clisp")
    #+lispworks (:file "cffi-lispworks")
    #+ecl (:file "cffi-ecl")
    #+allegro (:file "cffi-allegro")
    #+cormanlisp (:file "cffi-corman")
  • закладка нескольких вариантов построения библиотеки, в зависимсоти от каких-то условий. Тут проще всего привести примеры:
    ;; использовать ли acl-regexp2-engine?
    (defsystem :cl-ppcre
    :version "2.0.3"
    :serial t
    :components ((:file "packages")
    (:file "specials")
    (:file "util")
    (:file "errors")
    (:file "charset")
    (:file "charmap")
    (:file "chartest")
    #-:use-acl-regexp2-engine
    (:file "lexer")
    #-:use-acl-regexp2-engine
    (:file "parser")
    #-:use-acl-regexp2-engine
    (:file "regex-class")
    #-:use-acl-regexp2-engine
    (:file "regex-class-util")
    #-:use-acl-regexp2-engine
    (:file "convert")
    #-:use-acl-regexp2-engine
    (:file "optimize")
    #-:use-acl-regexp2-engine
    (:file "closures")
    #-:use-acl-regexp2-engine
    (:file "repetition-closures")
    #-:use-acl-regexp2-engine
    (:file "scanner")
    (:file "api")))
    ;; какие бэкенды генерации графических файлов доступны?
    (defsystem :ch-image
    ...
    (:module
    :io
    :components
    (#+ch-image-has-tiff-ffi
    (:cl-source-file "tiffimage")
    #+ch-image-has-cl-jpeg
    (:cl-source-file "jpegimage")
    #+(and ch-image-has-zpng)
    (:cl-source-file "pngimage")
    (:cl-source-file "imageio"
    :depends-on (#+ch-image-has-tiff-ffi
    "tiffimage"
    #+ch-image-has-cl-jpeg
    "jpegimage")))
    :depends-on (:src))


;; :name не имеет значения
CL-USER> (defsystem :ch-image
:name "ch-image1")
#<SYSTEM "ch-image" {AA7A911}>
CL-USER> (describe *)
#<SYSTEM "ch-image" {AA7A911}>
[standard-object]

Slots with :INSTANCE allocation:
NAME = "ch-image"
VERSION = #<unbound slot>
IN-ORDER-TO = NIL
DO-FIRST = ((COMPILE-OP (LOAD-OP)))
INLINE-METHODS = NIL
PARENT = NIL
RELATIVE-PATHNAME = #P"/home/vs/lib/lisp/ch-image_0.4.1/"
OPERATION-TIMES = #<HASH-TABLE :TEST EQL :COUNT 0 {AA7AB61}>
PROPERTIES = NIL
COMPONENTS = NIL
IF-COMPONENT-DEP-FAILS = :FAIL
DEFAULT-COMPONENT-CLASS = NIL
DESCRIPTION = #<unbound slot>
LONG-DESCRIPTION = #<unbound slot>
AUTHOR = #<unbound slot>
MAINTAINER = #<unbound slot>
LICENCE = #<unbound slot>

2010-07-09

Новости Redis и cl-redis

Наконец, дошли руки обновить наш клиент для Redis и доработать его для поддержки новых режимов, которые добавились в последних версиях БД. Заодно и проверить утверждения из статьи о том, что клиент тривиально расширяемый и легко адаптируется к изменениям.

На самом деле, пришлось немного повозиться. Но не потому, что утверждения ошибочны, а из-за стандартной проблемы подавляющего большинства софтверных проектов — неадекватной документации. Впрочем, в случае с Redis'ом все не однозначно. С одной стороны, в общем, документация хорошая и правильная: во-первых, не перегруженная, во-вторых, описан протокол взаимодействия, и для каждой команды более-менее указано, как она использует протокол (а еще и другие полезные вещи: иногда примеры использования, а также, что мне понравилось, временные характеристики). Но, в том то и дело, что "более-менее" указано, и некоторые важные моменты упущены, так что в этот раз пришлось лезть в код родного клиента redis-cli и даже прослушивать его взаимодействие с сервером tcpdump'ом (жалко, что я не додумался с этого начать :)

Короче говоря, у Redis появилась поддержка хеш-таблиц, но обнаружился баг у всех команд, которые передают ключи (в терминах Redis — "поля") в таблице (самый простой пример: HGET table field). Почему этого не заметили разработчики? Видимо, потому, что родной клиент использует для общения с сервером не описанный протокол с разными вариантами передачи команд: inline, bulk и т.п.,— а простой унифицированный способ в форме multi-bulk, т.е. вместо строки "HGET table field", которую посылал наш клиент, вот что:
"*3
$4
HGET
$5
table
$5
field"

Соответственно, наверно, и не заметили особенность при обработке полей в случае передачи команды в inline-форме.

Справедливости ради, нужно сказать, что если порыться в документации, то можно найти замечание, что "A good client library may implement unknown commands using this command format in order to support new commands out of the box without modifications." (т.е. самый продуктивный путь был — снова перечитать спецификацию протокола :) Теперь вот, задумался, может стоит перевести все команды на эту multi-bulk форму. И API упростится, будет не:
(def-cmd HGET (key field)
"Retrieve the value of the specified hash FIELD."
:generic :bulk)
а
(def-cmd HGET (key field) :bulk
"Retrieve the value of the specified hash FIELD.")
С другой стороны, немного уменьшиться производительность.

Вообще, Redis все в большем количестве мест использует multi-bulk форму (поскольку она наиболее общая). Поддержка PubSub сделана также на ней, хотя и с небольшим отклонением.

PubSub — это сейчас такой горячий пирожок, который все хотят съесть. Как это реализовано здесь? Есть команды SUBSCRIBE и PSUBSCRIBE, позволяющие подписаться на каналы соответственно по имени и по шаблону (типа "news.*"). И есть PUBLISH, которая посылает сообщения. Сообщения доставляются условно мгновенно и приходят в рамках тех активных соединений, в которых произведена подписка. Таким образом, типичный подход к применению этого, насколько я понимаю — это когда у нас есть отдельная нить-слушатель, которая обрабатывает приходящие сообщения и иницирует какую-то реакцию в программе. Где-то так:
(with-connection ()
(red-subscribe "chan")
(loop
(let ((msg (expect :multi)))
(bt:make-thread (lambda ()
(process (elt msg 2))))
;; или же, например
(bt:with-lock-held (*lock*)
(push (elt msg 2) *internal-queue*)))))
Сообщения имеют вид '("message" <канал> <сообщение>) для простой подписки и '(<шаблон> <канал> <сообщение>) для PSUBSCRIBE. Вот, собственно, и всё.

Как видно из примера, получение сообщений из канала блокирующее и выполняется просто за счет вызова функции expect, которая во всех обычных командах присутствует в паре tell-expect. Так что, возвращаясь к моим утверждениям про легкую расширяемость и адаптацию — они подтвердились (и один из примеров — вот он).

Redis действительно быстро развивается и много чего меняется, добавляются радикально новые варианты использования: в данном случае транзакции и PubSub. Но для поддержки всего этого в клиенте хватает точечных изменений на уровне реализации протокола, никакого рефакторинга. В этот раз нужно было добавить еще несколько вариантов ожидания ответа: :queued (для транзакций), при котором считывается сразу несколько разнородных ответов подряд; :float; а также :pubsub,— поменять несколько определений команд, потому что поменялась сама их спецификация. Ну и добавилась обработка особого случая транзакций, когда любая команда возвращает "QUEUED" вместо своего стандартного ответа.

PS. Да, и еще про транзакции: теперь, как видите, Redis и их поддерживает. Что меня заинтересовало — это обсуждение гарантий целостности (на этой же странице внизу), которые, на первый взгляд, недостаточны: нет условия успешного завершения всех команд в рамках транзакции, чтобы транзакция была признана успешной. Т.е. ROLLBACK не предусмотрен. Но вот, что пишет на этот счет Сальваторе Санфилиппо:
I think you are missing the point about MULTI/EXEC, that is, a Redis command only fails on syntax error or type mismatch. That is, in code without errors the transaction will either be executed as whole or nothing. Still it is true that if there are programming errors like using a list command against a set, or a syntax error, only the sane commands will be performed and the others instead will fail, but it's very hard for this to happen in production.

Так что транзакции в Redis кислотные по-своему, и нужно хорошо уяснить для себя их семантику, прежде чем браться применять. (И опять, возвращаясь к тому, с чего я начинал: встает проблема адекватности документации. А идеальная документация — исполняемая... ;)

Внутреннее устройство ASDF

Это вторая статья в серии про ASDF. Первая рассказывала про нововведения в ASDF 2.

Итак, рассказ о внутренностях ASDF начнем с того, что меня самого испугала бы задача создать с нуля подобную систему. В данном случае в идеале нужно единомоментно получить программу, обладающую одновременно такими довольно противоречивыми характеристиками:
  • хорошо покрывающую основные варианты использования (в случае ASDF — это и средство описания систем (для их последующего распространения), и менеджер сборки)
  • простую и удобную для непосвященных в детали пользователей
  • хорошо расширяемую для того, чтобы позволить развивать сопутствующую инфраструктуру (например, такие средства как ASDF-INSTALL)
  • ну и, разумеется, сразу корректно работающую
ASDF была впервые написана Деном Барлоу в 2001 году. Как я понимаю, подспорьем при ее создании был фундаментальный труд Кента Питмана, обобщающий опыт в этой сфере, "Описание больших систем" (1984 года), а также опыт эксплуатации ее предшественника MK:DEFSYSTEM. Т.е., по сути, ASDF была "второй системой", но в данном случае, к счастью, удалось избежать реализации соответствующего синдрома.

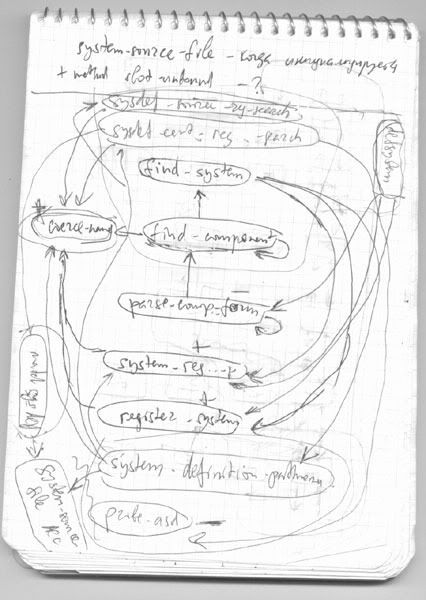
Что же представляет из себя эта сама по себе довольно большая система изнутри? Хребтом ASDF является иерархия классов componentmodulesystem, которые содержат информацию об именах, местоположении и зависимостях систем и их компонент, метаинформацию, а также служебную информацию самой ASDF.

Кроме того описаны классы операций, которые могут выполняться над системами, как то: compile-op, load-op, test-op и т.д. Почему операции являются объектами, а не просто ключами, что напрашивается на первый взгляд? Во-первых, это позволяет наследовать от них и при этом точечно менять поведение связанных обобщенных функций. Но даже более важно то, что объект операции имеет определенные свойства: операцию-родитель, является ли операция форсированной (хотя это свойство на данный момент не работает корректно), таблицы отработанных и еще не отработанных узлов и т.д. Это имеет и свой недостаток, поскольку кажется несколько избыточным для обычного пользователя. В версии ASDF 2 для его устранения введены функции-обертки load-system, compile-system и test-system.

На уровне пользовательского API на основе всех этих классов функционирует макро defsystem, а также обобщенная функция operate.

Defsystem — это хороший инструмент описания систем, знакомый и понятный, я думаю, каждому. Он ведет свою историю еще от Lisp Machine Lisp DEFSYSTEM, хотя с тех пор и существенно эволюционировал в сторону упрощения интерфейса.

Параметры defsystem-формы не передаются, как можно было бы предположить, напрямую в (make-instance 'system ...), а сперва обрабатываются функцией parse-component-form. При этом часть параметров передается как есть, а часть транслируется или используется в качестве мета-параметров. Остановлюсь на двух из них:
  • defsystem можно применять не только для стандартных систем, но и их потомков за счет параметра :class
  • параметр :depends-on:weakly-depends-on1), на самом деле, не присутствует в качестве слота в классе component. Его содержимое транслируется в содержимое слота in-order-to, которое описывает зависимости более гранулярно отдельно для каждой операции. Кстати, этот слот можно задать напрямую в defsystem-описании, чем иногда пользуются при необходимости указания нестандартных сценариев поведения. Впрочем, среди установленных у меня порядка 70 библиотек я нашел только несколько примеров такого использования, самый интересный из которых — в описании системы weblocks-prevalance (в остальных случаях это применяется для указания зависимостей систем-тестовых наборов). В данном случае устанавливается зависимость от дополнительно определенной операции prepare-prevalance-op:
(defsystem weblocks-prevalence
:name "weblocks-prevalence"
;; кстати, нет смысла задавать параметр `name' для системы,
;; поскольку имя берется из символа, передаваемого в defsystem
:description "A weblocks backend for cl-prevalence."
:depends-on (:metatilities :cl-ppcre :cl-prevalence :bordeaux-threads)
:components ((:file "prevalence"))
:in-order-to ((compile-op (prepare-prevalence-op :weblocks-prevalence))
(load-op (prepare-prevalence-op :weblocks-prevalence))))
А сама операция prepare-prevalence-op характеризуется всего одним дополнительным методом, отвечающим за подгрузку дополнительной системы, находящейся по внутреннему пути, не известному в *central-registry*:

(defmethod perform ((op prepare-prevalence-op)
(c (eql (find-system :weblocks-prevalence))))
(unless (find-package :weblocks-memory)
;; load weblocks if necessary
(unless (find-package :weblocks)
(asdf:oos 'asdf:load-op :weblocks))
;; load weblocks-memory.asd
(load (merge-pathnames
(make-pathname :directory '(:relative "src" "store" "memory")
:name "weblocks-memory" :type "asd")
(funcall (symbol-function
(find-symbol (symbol-name '#:asdf-system-directory)
(find-package :weblocks)))
:weblocks)))
;; load weblocks-memory
(asdf:oos 'asdf:load-op :weblocks-memory)))
Впрочем, это можно было бы сделать и иначе :)

Проблемой использования defsystem, которой я коснусь в следующей статье на тему шаблонов применения ASDF, является то, что есть соблазн отступить о чисто декларативного описания системы и добавить в него некоторые исполняемые элементы, например, чтение и подстановку версии системы из отдельного файла. Как по мне, было бы разумно обрабатывать эту форму в рамках (let ((*read-evel* nil) ...), чтобы исключить такие варианты. Причина тут в том, что ASDF-описание может обрабатыватся более, чем 1 раз при поиске систем и разрешении зависимостей, и работа с ним в таком случае выполняется в режиме просто чтения. Возможно, это ограничение будет со временем установлено: во всяком случае это уже обсуждалось в рассылке.

Теперь рассмотрим функцию operate, которая является точкой входа в область собственно ядра ASDF, которое отвечает за поиск и выполнение операций над зависимыми компонентами. Она опирается на обобщенные функции traverse, роль которой — в построении плана выполнения той или иной операции, и perform, которая собственно выполняет конечные действия, будь то компиляция, загрузка файлов и т.д, а также на функцию find-system. Кроме того, интересным дополнением (неким альтер-его) perform является explain, которая только указывает, какое действие должно быть выполнено. Хорошая иллюстрация возможностей применения explain дана в статье Питмана:
(DOLIST (STEP (SYSDEF:GENERATE-PLAN system :UPDATE))
(SYSDEF:EXPLAIN-ACTION system STEP)
(UNLESS (NOT (Y-OR-N-P "OK? "))
(SYSDEF:EXECUTE-ACTION system STEP)))
Этот код на Lisp Machine Lisp позволяет пошагово выполнять обновление системы при условии согласия пользователя на каждом шаге.

Операция traverse реализует алгоритм поиска и разрешения зависимостей ASDF. Сам по себе он не стоит отдельного рассмотрения, но что интересно, это то, что алгоритм может обрабатывать 3 типа зависимостей:
  • привычную простую форму (:depends-on (:cl-ppcre ...))
  • версионированную форму (:depends-on ((:version :cl-ppcre "1.2.3") ...))
  • зависимость от фичи (:depends-on ((:feature :x86) ...))
Ко второй форме мы еще вернемся в теме о поддержке версионности. А на счет третьей, то к ней относится интересный комментарий в коде ASDF: "Congratulations, you're the first ever user of FEATURE dependencies! Please contact the asdf-devel mailing-list." :)

Точкой входа в механизм поиска Лисп-систем в операционной системе является функция find-system, которая смоделированна на основе стандартной функции find-class. (Артефактом такого подобия является параметр errorp, необходимость в котором как здесь, так и в find-class и find-method, в которых также реализован этот подход, как по мне, по меньшей мере сомнительна). Find-system одновременно проверяет наличие системы среди уже загруженных (таблица таких систем со врменем последнего обновления находится в *defined-systems*), а также ищет на диске с помощью функции system-definition-pathname, которая в свою очередь раскручивает механиз поиска систем функциями, заданными в списке *system-definition-search-functions*. На данный момент в этом списке 2 основных функции: "классический" поиск в директориях, заданных в *central-registry*, и новый поиск в source-registry. Очень важной особенностью find-system, про которую не нужно забывать, это ее побочный эффект — загрузка ASD-файла системы в память и регистрация его в *defined-systems*.

Наконец, стоит еще упомянуть 2 обобщенные функции output-files и input-files, которые позволяют задавать способ точного определения полных имен файлов разных типов компонент по их короткому имени в описании системы.

В общем-то, это и всё ядро ASDF. Остальное — это ряд утилит для работы с операционной системой, среди которых несколько очень полезных функций, заслуживающих более широкой известности в Лисп-мире (например, run-shell-command, load-pathname, parse-windows-shortcut и другие), а также добавленные в ASDF 2 механизмы определения местонахождения FASL-файлов (в чем-то аналог ASDF-BINARY-LOCATIONS, для которого добавлен и compatibily mode) и работы с центральным реестром.


Разобравшись во внутренностях ASDF я пришел к довольно неожижанному для себя выводу: в ее основе лежит хорошо продуманный объектно-ориентированный дизайн, дающий воможность для ее эффективного применения не только непосредственно, но и как основы для других инструментов. Более того, используя ее как кейс, можно даже учить людей настоящему практическому объектно-ориентированному проектированию2. В то же время, этот дизайн, конечно, не идеален.
  • Во-первых, он сложен. И это действительно оправдано причинами, описанными вначале. Но все же временами наблюдается излишняя сложность. (Впрочем, эта проблема постепенно устраняется по мере развития кода). Сложность приводит к багам, некоторые из которых существуют до сих пор, на 10-м году жизни системы.
  • Во-вторых, он расширяемый, но тоже не до конца: ядро системы создано с оглядкой на последующую расширяемость, но в поддерживающем слое об этом иногда забывали.
  • В-третьих, он плохо описан. И это, пожалуй, самая большая проблема ASDF и хороший урок для любого проектировщика: ясная и полная документация имеет важнейшее значение для удачного использования сколь угодно хорошого дизайна.

И еще можно сказать, что ASDF намного ближе по своей философии к (качественным) продуктам "классических" системных языков, таких как С++ или Java, чем к распространенному в последнее время в Лиспе bottom-up стилю. В то же время, за счет использования полезных возможностей Лиспа: мультиметодов, функций высших порядков и т.п.,— он намного менее церемониален и многословен, так сказать, без перегрузки шаблонами проектирования.

В следующей статье — о некоторых шаблонах использования ASDF.


1 разница в том, что изменение "слабых" зависимостей не вызывает перекомпиляцию зависящих от них компонент
2 ... а не такому далекому на поверку от реальности, который можно увидеть, например, в знаменитой книге Гради Буча


И в придачу, непонятная визуализация того, как происходит поиск системы:)

2010-07-05

Уникальные технологии Common Lisp

Написано для: developers.org.ua
Время написания: октябрь 2008

Базовые подсистемы языка

В языке Common Lisp есть как минимум 3 инфраструктурных технологии, во многом формирующие подходы к его применению, которые в других языках либо отсутствуют вовсе, либо реализованы в очень ограниченном варианте. Для компенсации их отсутствия пользователи других языков часто вынуждены использовать Шаблоны проектирования, а порой и вообще не имеют возможности применять некоторые более эффективные подходы к решению типичных задач.

Что это за технологии и какие возможности дает их использование?

Макросистема

  • Это основная отличительная особенность Common Lisp, выделяющая его среди других языков. Ее реализация возможна благодаря использованию для записи Lisp-програм s-нотации (представления программы непосредственно в виде ее абстрактного синтаксического дерева). Позволяет программировать компилятор языка.

  • Позволяет полностью соблюдать один из основополагающих принципов хорошего стиля программирования DRY (не-повторяй-себя).

  • В отличие от обычных функций, аргументы, передаваемые макросам, не вычисляются, поэтому с их помощью можно создавать любые управляющие конструкции языка.

Примеры применения:
  1. Определение управляющих конструкций языка, которые могут использоваться на равне со стандартными (на самом деле практически все стандартные управляющие конструкции также являются макросами. Основу языка — “аксиомы”, которые невозможно определить через другие конструкции — составляют специальные операторы). В качестве примера можно привести анафорические управляющие конструкции (см. библиотеку Anaphora), которые, используя принцип “convention over configuration”, скрывают реализацию некоторых типичных шаблонов.

    Самый простой пример — макро AIF (или IF-IT), которое тестирует первый аргумент на истинность и одновременно привязывает его значение к переменной IT, которую, соответственно, можно использовать в THEN-clause:

    (defmacro aif (var then &optional else)
    `(let ((it ,var))
    (if it ,then ,else)))

    Учитывая то, что в CL ложность представляется константой NIL, которая также соответствует пустому списку, такая конструкция, например, часто применяется в коде, где сначала какие-то данные аккумулируются в список, а потом, если список не пуст, над ними производятся какие-то действия. Другой вариант, это проверить, заданно ли какое-то значение и потом использовать его:

    (defun determine-fit-xture-type (table-str)
    "Determine a type of Fit fixture, specified with TABLE-STR"
    (handler-case
    (aif (find (string-trim *spacers* (strip-tags (get-tag "td" (get-tag "tr" table-str 0) 1)))
    *fit-xture-rules* :test #'string-equal :key #'car)
    (cdr it)
    'row-fit-xture)
    (tag-not-found () 'column-fit-xture)))

    * В этой функции проверяется, есть ли во второй ячейке первой строки HTML таблицы какие-то данные и в соответствии с этим определяется тип привязки для Fit-теста. Переменной it присвоены найденные данные.

  2. Создание DSL‘ей для любой предметной области, которые могут иметь в распоряжении все возможности компилятора Common Lisp. Ярким примером такого DSL’я может служить библиотека Parenscript, которая реализует кодогенерацию JavaScript из Common Lisp. Используя ее, можно писать макросы для Javascript!
    (js:defpsmacro set-attr (id attr val)
    `(.attr ($ (+ "#" ,id)) ,attr ,val))

    * Простейший макрос-обертка для задания аттрибутов объекта, полученного с помощью селектора jQuery

  3. В форме локальных макросов (MACROLET) для модуляризации и разделения потоков вычислений внутри сложных функций, а также для соблюдения принципа DRY при написании лишь слегка отличающегося кода в различных местах одной функции.

  4. Наконец, создание инфраструктурных систем языка. Например, с помощью макросов можно реализовать продления (библиотека CL-CONT), ленивые вычисления (библиотека SERIES) и т.д.

  5. …ну и для многих других целей.
Больше по теме: Paul Graham, On Lisp

Мета-объектный протокол и CLOS

  • Основа объектной системы языка. Позволяет манипулировать представлением классов.

  • Методы не принадлежат классам, а специализируются на них, что дает возможность элегантной реализации множественной диспетчиризации. Также возможна специализация не по классу, а по ключу.

  • Уникальной является технология комбинации методов, позволяющая использовать стандартные способы комбинации: перед, после, вокруг,— а также определенные пользователем.

Примерами использования мета-объектного протокола также являются инфраструктурные системы языка, реализованные в виде библиотек:

  • object-persisance: Elephant, AllegroCache
  • работа с БД: CLSQL
  • интерфейс пользователя: Cells

Библиотека CLSQL создана для унификации работы с различными SQL базами данных. Кстати, на ее примере можно увидеть проявление мультипарадигменности Common Lisp: у библиотеки есть как объектно-ориентированный интерфейс (ORM), реализованный на основе CLOS, так и функциональный (на основе функций и макросов чтения).

С помощью мета-объектного протокола стандартный класс языка расширяется специальным параметром — ссылкой на таблицу БД, к которой он привязан, а описания его полей (в терминологии Lisp: слотов) — дополнительными опциональными параметрами, такими как: ограничение уникальности, ключа, функция-преобразователь при записи и извлечении значения из БД и т.д.

Больше по теме: Gregor Kiczales et al. The Art of Metaobject Protocol

Система обработки ошибок / сигнальный протокол

Система обработки ошибок есть в любом современном языке, однако в CL она все еще остается в определенном смысле уникальной (разве что в C# сейчас вводится нечто подобное). Преимущество этой системы заключается опять же в ее большей абстрактности: хотя основная ее задача — обработка ошибок, точнее исключительных ситуаций,— она построена на более общей концепции передачи управления потоком выполнения программы по стеку. …Как и системы в других языках. Но в других языках есть единственный предопределенный вариант передачи управления: после возникновения исключительной ситуации стек отматывается вплоть до уровня, где находится ее обработчик (или до верхнего уровня). В CL же стек не отматывается сразу, а сперва ищется соответствующий обработчик (причем это может делаться как в динамическом, так и в лексическом окружении), а затем обработчик выполняется на том уровне, где это определенно программистом. Таким образом, исключительные ситуации не несут безусловно катастрофических последствий для текущего состояния выполнения программы, т.е. с их помощью можно реализовать различные виды нелокальной передачи управления (а это приводит к сопроцедурам и т.п.) Хорошие примеры использования сигнального протокола приведены в книге Practical Common Lisp (см. ниже).

Больше по теме:

Вспомогательные технологии

Кроме того в CL есть ряд технологий менее значительных, которые нельзя назвать в полной мере уникальными, но которые существенно упрощают его применение и делают программы более ясными, а также дают дополнительные возможности для расширения языка:

Протокол множественных возвращаемых значений

Дает возможность возвращать из функции несколько значений и по желанию принимать все их (и привязывать к каким-то переменным) или только часть. По-умолчанию для кода, не использующего эту функциональность, передается только 1-е значение.

Казалось бы, это простая возможность, однако, на поверку, она требует обширной поддержки на языковом уровне (учитывая необходимость поддержки возврата из блоков и т.п.).

Протокол обобщенных переменных

Это аналог свойств в некоторых ОО-языках. Концептуально, оперирует понятием места (place) — по сути дела ячейки памяти, однако не физической (без манипуляции указателями) — это может быть просто объект или же элемент какой-то структуры (будь-то опять же объект, список, массив и т.д.) Таким образом, имеются намного большие возможности, чем при использовании обычных свойств, поскольку для любой функции, которая читает значения какого-либо места, можно указать функцию которая его значение задает.

Больше по теме: Paul Graham, On Lisp, Ch.12 “Generalized Variables”

Макросы чтения

Это инструмент модификации синтаксиса языка за пределы s-выражений, который дает программисту возможность, используя компилятор Lisp, создать свой собственный синтаксис. Его работа основана на фундаментальном принципе Lisp-систем: разделении времени чтения, времени компиляции и времени выполнения — REPL (Read-Eval-Print Loop). Обычные макросы вычисляются (раскрываются, expand) во время компиляции, и полученный код компилируется вместе с написанным вручную. А вот макросы чтения выполняются еще на этапе обработки программы парсером при обнаружении специальных символов (dispatch characters). Механизм макросов чтения является возможностью получить прямой доступ к Reader’у и влиять на то, как он формирует абстрактное синтаксическое дерево из “сырого” программного кода. Таким образом, можно на поверхности Lisp использовать любой синтаксис, вплоть до, например, C-подобного. Впрочем, Lisp-программисты предпочитают все-таки префиксный унифицированный синтаксис со скобками, а Reader-макросы используют для специфических задач.

Пример такого использования — буквальный синтаксис для чтения hash-таблиц, который почему-то отсутствует в спецификации языка. Это, кстати, еще один пример того, каким образом CL дает возможность изменить себя и использовать новые базовые синтаксические конструкции наравне с определенными в стандарте. Основывается на буквальном синтаксисе для ассоциативных списков (ALIST):


;; a reader syntax for hash tables like alists: #h([:test (test 'eql)] (key . val)*)
(set-dispatch-macro-character #\# #\h
(lambda (stream subchar arg)
(declare (ignore subchar)
(ignore arg))
(let* ((sexp (read stream t nil t))
(test (when (eql (car sexp) :test) (cadr sexp)))
(kv-pairs (if test (cddr sexp) sexp))
(table (gensym)))
`(let ((,table (make-hash-table :test (or ,test 'eql))))
(mapcar #'(lambda (cons)
(setf (gethash (car cons) ,table)
(cdr cons)))
',kv-pairs)
,table)))))

Больше по теме: Doug Hoyte, Let Over Lambda, Ch.4 “Read Macros”


Послесловие

В заключение хотелось бы коснуться понятия высокоуровневого языка программирования. Оно, конечно, является философским, поэтому выскажу свое мнение на этот счет: по-настоящему высокоуровневый язык должен давать программисту возможность выражать свои мысли, концепции и модели в программном коде напрямую, а не через другие концепции, если только те не являются более общими. Это значит, например, что высокоуровневый язык должен позволять напрямую оперировать такой сущностью, как функция, а не требовать для этого задействовать другие сущности такого же уровня абстракции, скажем, классы. Подход к созданию высокоуровневого языка можно увидеть на примере Common Lisp, в котором для каждой задачи выбирается подходящая концепция, будь то объект, сигнал или место. А что дает нам использование по-настоящему высокоуровневых языков? Большую расширяемость, краткость и адаптируемость программы к изменениям, и, в конце концов, настоящую свободу при программировании!